Powtarzalność i odtwarzalność
W poprzedniej sekcji pokazano, że binWidth należy do definicji pomiaru
tekstury. Ustalenie tego kontraktu jest konieczne, ale nie odpowiada na pytanie,
czy wynikowa cecha zachowuje się akceptowalnie, gdy warunki, które powinny
pozostawić cel pomiaru bez zmian, są powtarzane lub celowo modyfikowane. Cecha
może być precyzyjnie zdefiniowana, a mimo to pozostawać wrażliwa na zmianę
ułożenia, rekonstrukcję, segmentację lub warunki akwizycji.
Jest to pytanie o właściwości pomiarowe. Trzeba je oddzielić od późniejszych pytań o to, czy cecha ma znaczenie biologiczne, przewiduje wynik albo poprawia decyzję kliniczną. Analiza zgodności opisuje zachowanie zdefiniowanego pomiaru w zadeklarowanym porównaniu. Nie nadaje pomiarowi statusu biomarkera.
Trzy pytania, trzy warunki porównania
Słowa „odtwarzalność” często używa się w odniesieniu do kilku różnych eksperymentów. Należy je rozdzielić, ponieważ każdy zmienia inną część systemu pomiarowego.
| Pytanie | Warunki porównania | Główne pytanie |
|---|---|---|
| Powtarzalność | ten sam pacjent, ten sam skaner, ta sama sesja | Czy cecha pozostaje podobna w niemal identycznym pomiarze powtórnym? |
| Zgodność między rekonstrukcjami lub odporność na rekonstrukcję | ta sama akwizycja, inna rekonstrukcja | Czy cecha pozostaje zgodna, gdy zmienia się wybór rekonstrukcji? |
| Odtwarzalność | różne skanery, ośrodki lub protokoły | Czy cecha pozostaje zgodna w szerszym zakresie warunków akwizycji? |
Powtarzalność ma badać zmienność w warunkach, w których oczekuje się niewielkiej zmiany celu pomiaru. Zaobserwowana różnica może jednak obejmować zmianę ułożenia, fizjologię, szum akwizycji, zmienność segmentacji, wpływ geometrii i przetwarzania wstępnego oraz zmienność ekstrakcji. Zgodność między rekonstrukcjami stawia węższe pytanie, zmieniając zadeklarowaną oś rekonstrukcji, a zachowując akwizycję jako podstawę porównania. Odtwarzalność pyta o skutki różnic wielu warunków akwizycji, dlatego wymaga dokładnego opisu zmienionych skanerów, ośrodków, protokołów i innych czynników.
Porównania te mogą korzystać z powiązanych danych, lecz nie są wymiennymi analizami. Powtórzenie u tego samego pacjenta nie staje się eksperymentem rekonstrukcyjnym tylko dlatego, że oba obrazy mają różne etykiety plików. Z drugiej strony porównanie dwóch rekonstrukcji jednej akwizycji nie dowodzi odtwarzalności między ośrodkami. Zamierzone porównanie i źródło zmienności trzeba zadeklarować przed interpretacją współczynnika. Zagadnienia statystyczne związane z powtarzalnością i odtwarzalnością obrazowych biomarkerów ilościowych omawiają Ye, Lim i Huang.
Zgodność opisuje badany łańcuch pomiarowy
Współczynniki korelacji wewnątrzklasowej i współczynniki korelacji zgodności mogą podsumowywać zgodność lub rzetelność pomiarów sparowanych, ale współczynnik należy do eksperymentu, który go wytworzył. Nie jest wewnętrzną etykietą przypisaną do nazwy cechy.
Współczynnik test–retest oblicza się z wartości wytworzonych przez cały badany łańcuch: akwizycję obrazu, rekonstrukcję, ułożenie pacjenta, segmentację, geometrię, przetwarzanie wstępne, dyskretyzację i implementację cechy. Jeśli współczynnik jest niski, uzasadniony wniosek brzmi, że cecha nie była zgodna w ramach tego łańcucha i w tych warunkach. Sam współczynnik nie wskazuje, czy główny wkład pochodził z rekonstrukcji, maski, szumu obrazu, przetwarzania wstępnego czy innego ogniwa.
Rozróżnienie to dotyczy również skali współczynnika. CCC ocenia zgodność z prostą identyczności, natomiast ICC porównuje zmienność pomiarów powtórnych ze zmiennością między osobami w ramach określonej postaci ICC. Na oba wpływają kohorta i konwencja estymatora. Ta sama bezwzględna różnica między skanami może dać inny współczynnik względny w wąskiej kohorcie i w kohorcie o szerszym zakresie wartości cechy. Współczynnik nie zastępuje zatem różnic sparowanych, ich rozkładu ani analizy błędu bezwzględnego.
Dlatego niska wartość zgodności sama w sobie nie stanowi rozpoznania błędu segmentacji. Jest dowodem dotyczącym badanego procesu pomiarowego. Wskazanie prawdopodobnego źródła wymaga dodatkowych kontrastów eksperymentalnych z jawnymi założeniami.
Kontrasty diagnostyczne i ich założenia
Jeden z kontrastów wykorzystuje ten sam obraz i niezależne segmentacje. Jeśli obraz i procedura ekstrakcji pozostają stałe, a maski się różnią, wynikowa różnica bada przede wszystkim zmienność segmentacji. Nie izoluje jej jednak doskonale, jeśli proces segmentacji zmienia również geometrię, reprezentację etykiety lub przetwarzanie wstępne.
Inny kontrast wykorzystuje zarejestrowane obrazy powtórne i jedną przeniesioną maskę. Ogranicza to zmienność wynikającą z niezależnych segmentacji, ale zachowuje wpływ obrazu powtórnego, rejestracji i przeniesienia maski. Rejestracja i przeniesienie wprowadzają własne założenia oraz błędy. Większa wartość zgodności w tym kontraście nie dowodzi dokładności segmentacji, podobnie jak mniejsza wartość nie wskazuje jednego konkretnego błędu.
Są to projekty diagnostyczne, a nie zamienniki głównego estymandu powtarzalności lub odtwarzalności. Pomagają zawęzić zbiór prawdopodobnych wyjaśnień. Wynik pozostaje zależny od porównania, które rzeczywiście przeprowadzono.
Perturbacja jest eksperymentem pomiarowym
Sparowany zbiór danych test–retest jest cenny, ale to samo rozumowanie można zastosować do kontrolowanych perturbacji. Należy zmienić jedną zadeklarowaną część procesu pomiarowego, taką jak niewielkie przesunięcie granicy, wybór interpolacji, siatka resamplingu lub parametr dyskretyzacji, zachowując zamierzony obiekt i pozostałą część kontraktu, a następnie zmierzyć dryf cechy.
Syntetyczna perturbacja granicy uwidacznia tę logikę:
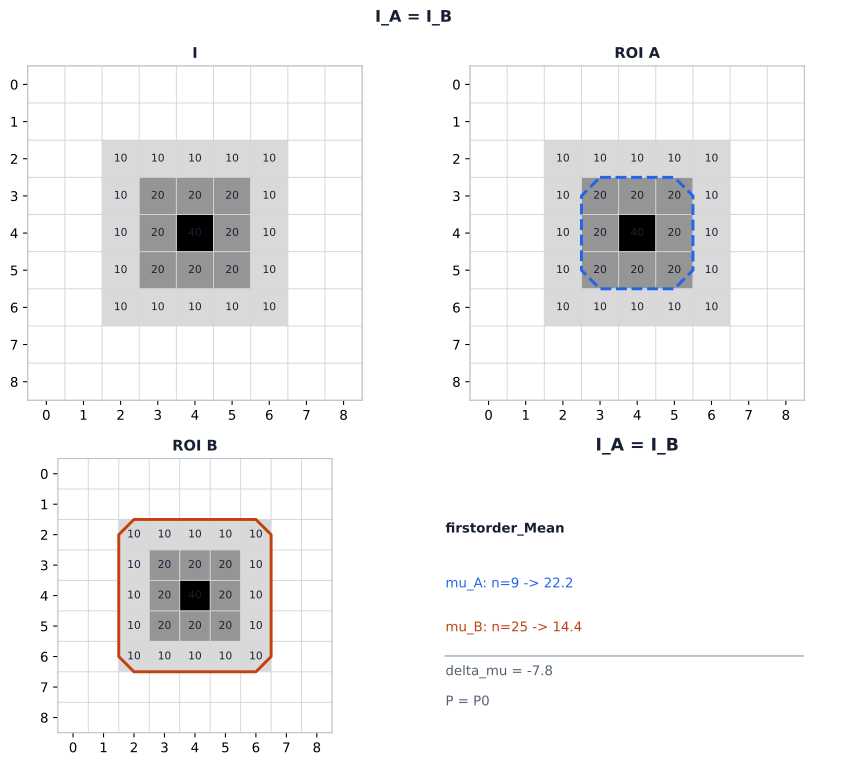
W tym syntetycznym przykładzie zmienia się tylko granica ROI, dlatego zmieniona wartość ilustruje wrażliwość pomiaru, a nie zmianę obiektu.
Zmieniona liczba w tym przykładzie nie dowodzi zmiany obiektu syntetycznego. Dowodzi, że cecha reaguje na zmieniony region. W rzeczywistej analizie ta sama interpretacja dotyczy kontrolowanej zmiany rekonstrukcji lub dyskretyzacji: wynik opisuje wrażliwość na tę część kontraktu, a nie odpowiedź biologiczną.
Analiza perturbacji i analiza test–retest odpowiadają na powiązane, lecz różne pytania. Test–retest pyta, co dzieje się przy określonej powtórnej akwizycji. Analiza perturbacji pyta, co dzieje się pod wpływem celowo wybranej zmiany obrazu, regionu lub przetwarzania. Żadna z metod nie wskazuje przyczyny bez projektu, który zmienia odnośne ogniwo, kontrolując pozostałe.
Stabilność nie jest trafnością biomarkera
Stabilność jest właściwością pomiaru w określonych warunkach. Nie dowodzi, że pomiar reprezentuje zamierzoną biologię. Cecha może być stabilna, ponieważ koduje trwałą właściwość akwizycji lub segmentacji, a nie interesujący proces biologiczny. Z drugiej strony cecha może przewidywać w jednym stałym środowisku akwizycji, pozostając wrażliwa na zmianę, która wystąpi po zmianie środowiska.
Pytania te pozostają więc odrębne. Właściwości pomiarowe dotyczą tego, czy wartość zachowuje się spójnie w zadeklarowanym porównaniu. Trafność biologiczna dotyczy tego, czy reprezentuje zamierzony cel. Predykcja dotyczy tego, czy model wykorzystujący tę wartość działa dla określonego wyniku i populacji. Użyteczność kliniczna dotyczy tego, czy wykorzystanie wyniku korzystnie zmienia decyzję lub wynik leczenia. Dowody z jednego poziomu nie odpowiadają automatycznie na pytanie z następnego.
Takie rozdzielenie zapobiega również odrzucaniu niestabilnej cechy na podstawie bezwzględnego hasła. To, czy określony stopień niestabilności jest akceptowalny, zależy od zamierzonego zastosowania, skali błędu cechy, odpowiedniego progu decyzyjnego i warunków użycia pomiaru. Właściwą odpowiedzią może być wykluczenie cechy, modelowanie jej niepewności, ograniczenie twierdzenia albo zaraportowanie ograniczenia. Decyzja ta wynika z zamierzonego estymandu i modelu błędu, a nie z samej nazwy rodziny.
Progi są konwencjami, a nie prawami
W badaniach często stosuje się próg ICC lub CCC, aby podsumować, które cechy spełniają zadeklarowaną konwencję stabilności. Taki próg może być przydatnym opisowym punktem odniesienia, jeśli zostanie wybrany z góry i zinterpretowany w ramach celu badania. Nie jest prawem pomiaru, uniwersalną granicą jakości ani dowodem trafności każdej cechy powyżej progu.
Współczynnika leżącego blisko progu nie należy traktować jako zasadniczo innego od współczynnika tuż poniżej. Zamiast sprowadzać eksperyment do liczby cech zachowanych i odrzuconych, należy raportować oszacowania na poziomie cech, niepewność oraz rozkład wyników. Próg może również ukrywać, że różne cechy w obrębie jednej rodziny odmiennie reagują na tę samą perturbację.
Opis stabilności i wykorzystanie stabilności do wyboru danych wejściowych modelu predykcyjnego są różnymi operacjami. Pierwsza może być analizą właściwości pomiarowych z własnym, określonym z góry porównaniem. Druga jest selekcją cech. Jeśli selekcja rozstrzyga, które kolumny wchodzą do modelu, należy do określonego z góry projektu tworzenia i walidacji modelu. Wytyczne raportowania, takie jak lista kontrolna raportowania badań radiomicznych CLEAR i TRIPOD+AI, traktują selekcję cech i rozdzielenie tworzenia modelu od jego oceny jako elementy projektu podlegające raportowaniu; nie stanowią empirycznej walidacji wynikowego modelu. Odpowiednie etapy dopasowywane lub selekcyjne muszą być ograniczone do danych dostępnych dla danej części projektu, a następnie zastosowane do danych wydzielonych bez ponownego dopasowania.
Empiryczne uzasadnienie filtrowania na podstawie stabilności jest więc zależne od kontekstu, a nie gwarantuje poprawy predykcji. Badanie selekcji opartej na rzetelności może wykazać korzyść w jednym środowisku, podczas gdy inne kohorty, definicje cech, punkty końcowe lub projekty walidacji mogą dać inny wynik. Korzyść trzeba wykazać dla zamierzonego zadania predykcyjnego; nie można jej założyć na podstawie współczynnika stabilności. Badanie rzetelności autorstwa Müller-Franzes i wsp. jest jednym z publicznie dostępnych przykładów pokazujących, dlaczego pytanie o selekcję należy zbadać, a nie uznać za rozstrzygnięte.
Praktyczna zasada jest prosta: najpierw scharakteryzuj zdefiniowany pomiar, zachowaj widoczność porównania i jego założeń, a późniejszą selekcję na podstawie stabilności traktuj jako decyzję modelową wymagającą własnych dowodów walidacyjnych. Samo przekroczenie progu nie czyni cechy godną zaufania, a cecha poniżej przyjętej konwencji nie dowodzi, że eksperyment był bezużyteczny.
Następna sekcja przekształca te rozróżnienia w ograniczone studium przypadku z wykorzystaniem sparowanych danych obrazowych: RIDER jako eksperyment dotyczący odporności rozdziela powtarzalność u tego samego pacjenta od zgodności między rekonstrukcjami i wykorzystuje kontrolowane perturbacje, aby połączyć prognozę zachowania pomiaru z zaobserwowanym wynikiem.
Źródła
- Ye S, Lim JY, Huang W. Statistical considerations for repeatability and reproducibility of quantitative imaging biomarkers. BJR Open. 2022;4(1):20210083. doi:10.1259/bjro.20210083, PMID 36452056.
- Lin LI. A concordance correlation coefficient to evaluate reproducibility. Biometrics. 1989;45(1):255-268. doi:10.2307/2532051, PMID 2720055.
- Pfaehler E, et al. Phys Imaging Radiat Oncol. 2021;20:69-75. doi:10.1016/j.phro.2021.10.007, PMID 34816024.
- Haarburger C, et al. Scientific Reports. 2020;10:12688. doi:10.1038/s41598-020-69534-6.
- Müller-Franzes et al. Diagnostics. 2022;12(2):247. PMID 35204338.
- Kocak B, et al. CLEAR radiomics reporting checklist. Insights into Imaging. 2023;14:75. doi:10.1186/s13244-023-01415-8.
- Collins GS, Moons KGM, Dhiman P, et al. TRIPOD+AI statement. BMJ. 2024;385:e078378. doi:10.1136/bmj-2023-078378.
© 2026 Adrian Tkacz · BioMedical-IT
Oryginalne teksty i ilustracje są udostępniane na licencji Creative Commons Uznanie autorstwa–Użycie niekomercyjne 4.0 Międzynarodowe (CC BY-NC 4.0), o ile nie zaznaczono inaczej. Przy ponownym wykorzystaniu proszę podać Adrian Tkacz / BioMedical-IT jako autora i zamieścić odnośnik do oryginalnego źródła. Materiały osób trzecich zachowują własne prawa i warunki licencyjne.