Granice dopasowanego stanu i wycieku informacji
Zbiór testowy jest obcy, a nie współpracownikiem
Wyciek najlepiej rozumieć jako problem dopasowanego stanu. Przekształcenie lub model ma stan, gdy dane wyznaczają parametry, wybrane zmienne, progi, wagi albo inne wybory, które zostaną później wykorzystane. Podczas oceny stan ten musi zostać wyznaczony w dozwolonym świecie treningowym. Świat danych wydzielonych można przekształcić za pomocą zamrożonego stanu i wykorzystać do obliczenia wyniku, ale nie może on pomagać w tworzeniu stanu, który zostanie na nim oceniony.
Jest to precyzyjniejsze niż krótka reguła „nie dopasowuj do zbioru testowego”. W badaniu obrazowym granicę może przekroczyć statystyka skalowania, model imputacji, próg dyskretyzacji, wybrany zbiór cech, wybór hiperparametru, model harmonizacji albo model segmentacji, którego pacjenci treningowi pokrywają się z pacjentami ocenianymi. Tabela może nie zawierać żadnej oczywistej etykiety testowej, a mimo to świat oceny mógł już wpłynąć na ukształtowanie danych wejściowych.
Katalog wycieków
Audyt powinien nazywać stan wytwarzany przez każdy etap oraz dane, na których wolno go dopasować. Przetwarzanie wstępne dopasowywane do kohorty wykorzystuje informacje z więcej niż jednej próbki: średnie i odchylenia standardowe do skalowania, parametry imputacji, bazę PCA, statystyki wyboru cech albo model efektu partii. Stany te należą do odpowiedniej części treningowej projektu walidacji, a następnie są stosowane do części wydzielonej.
Wybór cech jest granicą szczególnie łatwą do przeoczenia. Wybranie najlepszych cech z całej kohorty przed walidacją krzyżową wykorzystuje relacje między cechami a wynikiem w wierszach wydzielonych, nawet jeśli końcowa regresja jest dopasowywana osobno w każdym foldzie. Przeszukiwanie hiperparametrów ma tę samą strukturę. Jeśli wiele konfiguracji kandydujących porównuje się w foldach, które zostaną później użyte do raportowania, selekcja odczytała już wyniki oceny. Projekt zagnieżdżony w następnej sekcji rozdziela te operacje.
Segmentacja tworzy kolejną granicę. Maska wygenerowana przez model trenowany na pacjentach pokrywających się z pacjentami ocenianymi nie jest niezależnym wejściem tylko dlatego, że późniejszy ekstraktor cech nigdy nie widział wyniku. Pochodzenie maski, w tym dane użyte do trenowania modelu segmentacji i wszelkie przetwarzanie końcowe wykorzystujące informacje o celu, jest częścią procedury predykcyjnej.
Przetwarzanie segmentacji wykorzystujące informacje o celu oznacza tutaj użycie informacji z ocenianego obiektu docelowego, takich jak przynależność pacjenta, etykiety, wyniki lub wydzielone obrazy, do trenowania, strojenia, korygowania, progowania lub filtrowania maski. Jeśli model segmentacji trenowano na pacjentach pokrywających się z ocenianymi albo przetwarzanie końcowe wykorzystywało informacje z oceny, potok maski przeniósł informacje przez granicę i niezależność oceny została naruszona. Segmenter może być stałym komponentem tylko wtedy, gdy określono pochodzenie jego danych treningowych i ich relację do ocenianych pacjentów; określenie „stały” opisuje sposób jego zastosowania, a nie automatycznie sposób trenowania. Takie rozliczenie na poziomie komponentów stosuje pytania o granicę informacyjną i raportowanie pochodzące z wytycznych dotyczących wycieku, ryzyka błędu systematycznego i raportowania radiomiki; źródła te same w sobie nie walidują konkretnego modelu segmentacji.
Określenie „stałe przetwarzanie wstępne” również wymaga ostrożności. Operacja wykonywana osobno dla każdej próbki ze stałymi zadeklarowanymi przed oceną może nie estymować statystyki kohorty; jest to inna sytuacja niż wybór stałych po obejrzeniu całego zbioru danych lub wyników. Wybór projektowy może być stały podczas wdrożenia, a mimo to wykorzystywać informacje testowe, jeśli dokonano go po obejrzeniu danych wydzielonych. Istotne pytanie nie dotyczy wyłącznie tego, czy biblioteka dopasowała parametr, lecz tego, czy informacje z oceny wpłynęły na wybór mający znaczenie dla raportowanej procedury.
Przejście przez potok
Rozważmy celowo zwięzły potok radiomiczny:
CT + mask -> fixed intensity handling -> fixed resampling -> feature extraction -> feature scaling -> feature selection -> tuned model -> held-out scorePierwsze operacje mogą być stałymi przekształceniami wykonywanymi osobno dla każdej próbki, jeśli ich stałe i implementację określono niezależnie od danych do oceny. Skaler, reguła wyboru cech i strojony model wytwarzają dopasowane stany lub od nich zależą. Muszą być dopasowywane na dozwolonych danych treningowych w każdej jednostce walidacji. Jeśli używa się modelu harmonizacji lub imputacji, traktuje się go tak samo. Wiersze wydzielone są przekształcane za pomocą uzyskanego stanu i służą wyłącznie do obliczenia wyniku.
Rozróżnienie to widać na zachowanym schemacie granicy wycieku:
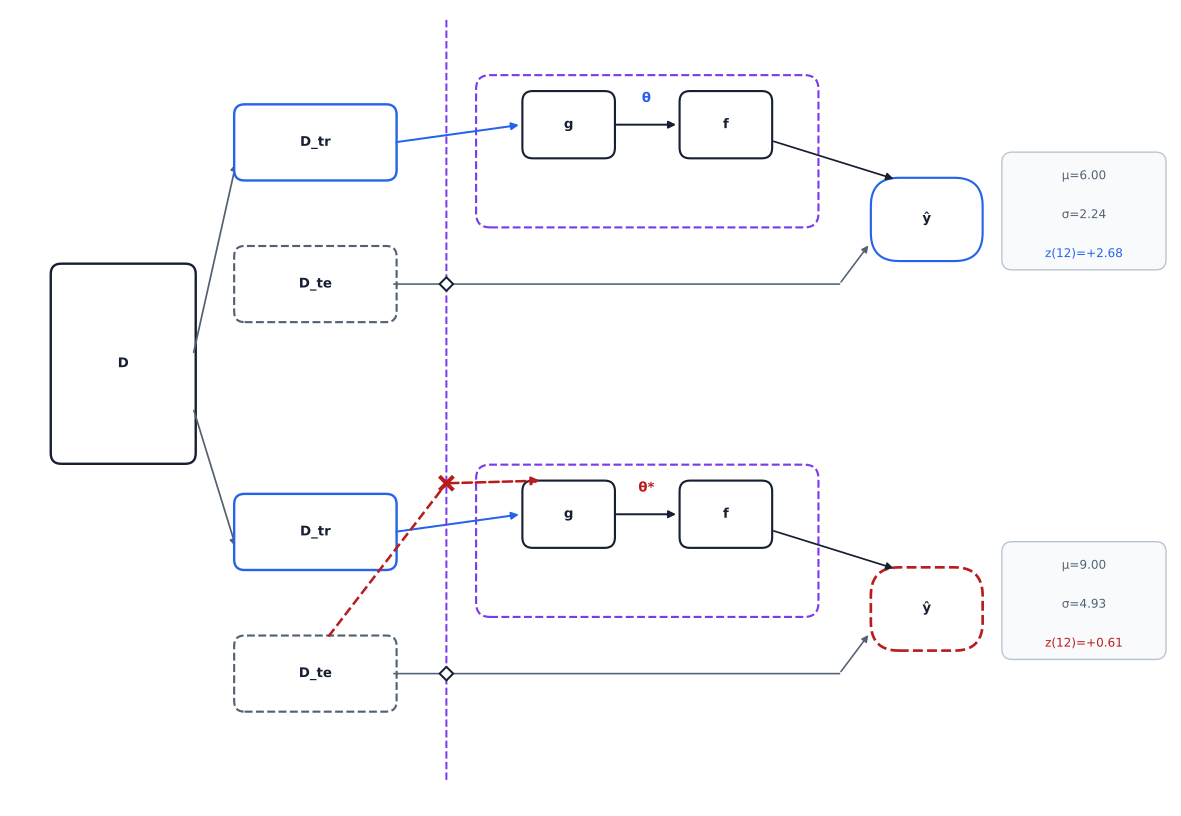
D_tr i D_te oznaczają część treningową i wydzieloną. W wariancie czystym
g dopasowuje stan na podstawie D_tr, zanim zastosuje go do którejkolwiek
części, a f jest trenowany na przekształconych wierszach treningowych. W
wariancie zanieczyszczonym wiersze wydzielone pomagają wyznaczyć stan używany do
ich oceny. Pokazana na istniejącym schemacie próba liczbowa jest ilustracyjną
konstrukcją tej granicy, a nie uniwersalną wielkością ani kierunkiem efektu.
Szczegół implementacyjny ma znaczenie, ponieważ wynik opisuje całą ocenianą procedurę, łącznie z miejscem wyznaczenia jej dopasowanych stanów. Przeniesienie operacji zależnej od danych poza pętlę zmienia tę procedurę; oszacowanie uzyskane za pomocą zanieczyszczonej procedury może nie być prawidłowym oszacowaniem dla zamierzonej procedury korzystającej wyłącznie z danych treningowych.
Wyciek i skróty pozostają odrębnymi problemami
Wyciek dotyczy procesu, w którym informacje dostały się do tworzenia modelu. Skrót dotyczy informacji wykorzystywanych przez model już po jego utworzeniu. Model może być wolny od wycieku, a mimo to zależeć od znacznika ośrodka, który nie przeniesie się do innego środowiska. Może też używać zamierzonego sygnału, lecz raportować optymistyczny wynik, ponieważ skaler lub selektor odczytał wiersze wydzielone. Testowanie zewnętrzne nie może wstecznie nadać ważności wewnętrznemu oszacowaniu obciążonemu wyciekiem, a dopasowywanie osobno w foldach nie dowodzi, że skrót przenosi się do innego środowiska.
W prostym audycie należy zapisać wiersz dla każdej operacji i odpowiedzieć na cztery pytania: jakie dane może odczytać, jaki stan lub wybór wytwarza, gdzie ten stan jest przechowywany i na której granicy może zostać zastosowany? Odpowiedź powinna być dostępna przed interpretacją wyniku. Audyt ten zmienia wyciek z ogólnego ostrzeżenia w identyfikowalną właściwość potoku.
Następna sekcja stosuje tę samą regułę informacyjną do subtelniejszego przypadku, w którym sam model jest wybierany w drodze przeszukiwania: pętla dokonująca wyboru musi znajdować się wewnątrz pętli estymującej działanie modelu.
Źródła
- Bernett J, et al. Guiding questions to avoid data leakage in biological machine learning applications. Nature Methods. 2024;21:1444-1453. doi:10.1038/s41592-024-02362-y.
- Collins GS, Moons KGM, Dhiman P, et al. TRIPOD+AI statement. BMJ. 2024;385:e078378. doi:10.1136/bmj-2023-078378.
- Moons KGM, Damen JAA, Kaul T, et al. PROBAST+AI. BMJ. 2025;388:e082505. doi:10.1136/bmj-2024-082505.
- Kocak B, et al. CLEAR. Insights into Imaging. 2023;14:75. doi:10.1186/s13244-023-01415-8.
© 2026 Adrian Tkacz · BioMedical-IT
Oryginalne teksty i ilustracje są udostępniane na licencji Creative Commons Uznanie autorstwa–Użycie niekomercyjne 4.0 Międzynarodowe (CC BY-NC 4.0), o ile nie zaznaczono inaczej. Przy ponownym wykorzystaniu proszę podać Adrian Tkacz / BioMedical-IT jako autora i zamieścić odnośnik do oryginalnego źródła. Materiały osób trzecich zachowują własne prawa i warunki licencyjne.