Niepewność dla danych sparowanych i odtwarzalność
Współczynnik zgodności nadal jest tylko estymatą punktową. Jeśli w badaniu podano CCC obliczony na podstawie kilkudziesięciu sparowanych skanów, naturalne jest pytanie, jak bardzo estymata ta zmieniałaby się w porównywalnych próbach. Bootstrap daje jeden ze sposobów przybliżenia tej niepewności próbkowania bez udawania, że obserwowana kohorta zawiera więcej informacji biologicznej niż w rzeczywistości.
Jedna kohorta, jedna statystyka, ponownie próbkowana
Przedział ufności opisuje zmienność statystyki w hipotetycznych powtórzeniach badania. Zazwyczaj nie można wielokrotnie powtórzyć badania, dlatego bootstrap traktuje obserwowaną kohortę jako empiryczny substytut i symuluje powtórzenia, losując z niej ze zwracaniem. Każda replikacja ma tę samą liczbę obserwacji co próba pierwotna. Niektóre osoby pojawiają się więcej niż raz, a inne zostają pominięte; replikacja jest zmianą wag obserwowanego rozkładu empirycznego, a nie nową kohortą.
Dla przykładowej czteroosobowej kohorty o wartościach A = 10, B = 12, C = 18 i D = 20 obserwowana średnia wynosi 15. Jedną z możliwych prób bootstrapowych jest A, A, C, D ze średnią 14,5. Inną jest B, C, C, D ze średnią 17,0. Trzecia to A, B, C, D, która odtwarza pierwotną średnią. Replikacja bootstrapowa obejmuje losowanie oraz ponowne obliczenie statystyki. Powtarzanie tej operacji tworzy empiryczny rozkład próbkowania, z którego można odczytać przedział percentylowy.
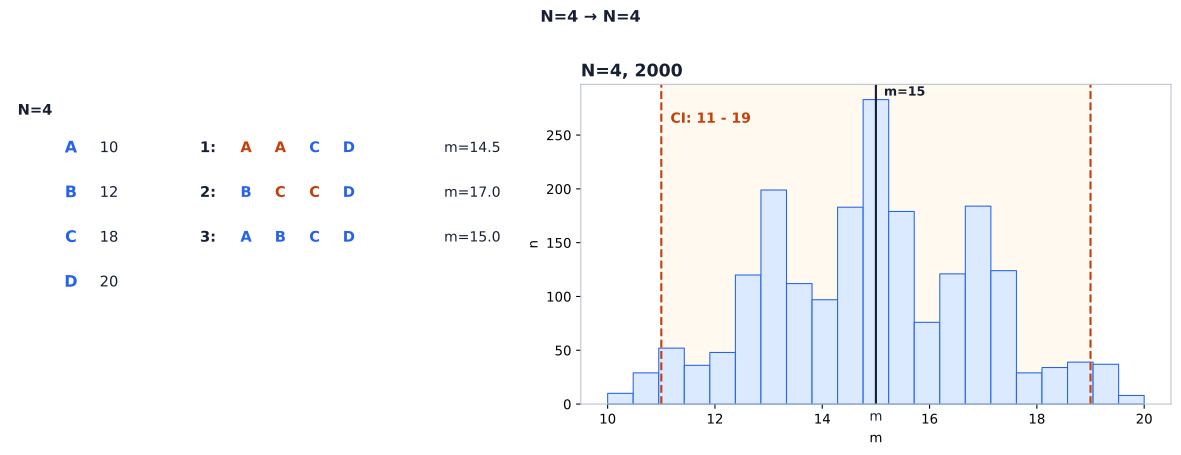
Kohorta i przedział są ilustracjami syntetycznymi. Przedział percentylowy nie jest dokładny ani wolny od założeń, a liczba replikacji, ziarno, reguła wyznaczania percentyli i zasada ważności są wyborami protokołu, nie uniwersalnymi zaleceniami. Stałe ziarno zwiększa możliwość powtórzenia obliczenia tylko wtedy, gdy ustalone są również generator, oprogramowanie, kod, dane i kolejność przetwarzania.
Para jest jednostką próbkowania
Dane test-retest zawierają po jednej parze na osobę:
(scan 1 value, scan 2 value). Bootstrap musi losować osoby i
przenosić razem oba elementy każdej pary. Niezależne losowanie wartości ze skanu
1 i skanu 2 tworzy pary, które nigdy nie istniały. Uzyskana statystyka odpowiada
na inne pytanie, ponieważ zniszczono relację wewnątrzosobniczą, którą ma mierzyć
analiza zgodności.
Ta sama reguła obowiązuje poza bootstrapem. Podział na poziomie pacjenta jest konieczny, gdy obserwacje wyjściowe i kontrolne należą do tej samej jednostki analizy, a każde dopasowywane przetwarzanie wstępne lub wybór muszą respektować tę jednostkę. Jednostka ponownego próbkowania wynika z estymandu i struktury zależności, a nie z wygodnego argumentu przekazanego funkcji bibliotecznej.
Nieprawidłowe replikacje pozostają widoczne
Próba bootstrapowa może nie spełniać zadeklarowanych wymagań estymatora dotyczących skończoności danych albo zmienności. Na przykład w przypadku CCC stałe wektory mogą sprawić, że współczynnik będzie niezdefiniowany; inny estymator może mieć inne warunki ważności. Taka replikacja jest nieprawidłowa dla danej statystyki. Należy ją zliczyć i zaraportować, a nie zastępować 0, 1 albo estymatą punktową. Analiza powinna zadeklarować regułę ważności estymatora oraz ujawnić liczbę replikacji niezdefiniowanych lub z innych powodów nieprawidłowych. Każdy próg udziału prawidłowych replikacji oraz decyzja, czy przedział zostanie podany, są zasadami właściwymi dla danej analizy, a nie uniwersalnymi regułami CCC. Jeśli sama estymata punktowa nie może zostać zaraportowana, bootstrap należy oznaczyć jako niewykonany, zamiast przedstawiać go tak, jakby oceniono nieprawidłowe replikacje.
Takie rozliczenie dostarcza więcej informacji niż dopracowany przedział bez zapisu liczby nieudanych obliczeń. Zapobiega też cichemu zmienianiu progu ważności po obejrzeniu przedziału. Powiązane studium przypadku z laboratorium może zamrozić takie wartości jak żądana liczba replikacji, ziarno, granice percentylowe i próg udziału prawidłowych replikacji; wartości te opisują dane, opatrzone datą studium przypadku, a nie zalecenie dla każdej analizy CCC.
Czego bootstrap nie może naprawić
Bootstrap estymuje niepewność przy założeniu rozkładu empirycznego reprezentowanego przez obserwowaną kohortę. Nie dodaje pacjentów, nie usuwa obciążenia selekcji ani nie czyni kohorty reprezentatywną dla osób, których nie objęła próba. Wąski przedział wokół obciążonego pomiaru nadal jest wąskim przedziałem wokół obciążonego pomiaru. Małe kohorty i obserwacje o dużym wpływie mogą sprawić, że zarówno estymata, jak i jej przedział będą wrażliwe na obserwowaną próbę, dlatego przedziałowi powinny towarzyszyć sparowane różnice, ich rozkład, wykres rozrzutu względem prostej identyczności oraz wykres różnicy względem średniej.
CCC zależy również od zakresu wartości między osobami. W prostym przykładzie
błędu dla danych sparowanych z Y = X + 1 wektory o wąskim zakresie
X = [10, 11, 12, 13] i Y = [11, 12, 13, 14] mają CCC = 0.714 przy
momentach 1/N. Wektory o szerokim zakresie X = [10, 20, 30, 40] i
Y = [11, 21, 31, 41] mają CCC = 0.996. W obu przykładach przesunięcie
bezwzględne wynosi jedną jednostkę. Współczynnik zmienia się, ponieważ to samo
przesunięcie stanowi inny udział obserwowanej zmienności. Niski CCC może zatem
wskazywać słabą zgodność względną, nie określając błędu bezwzględnego w
jednostkach cechy.
Ziarno jest informacją o proweniencji, a nie dowodem
Generator pseudolosowy odwzorowuje stan wewnętrzny na wynik losowania i kolejny
stan. Ziarno wybiera stan początkowy, dlatego to samo ziarno może odtworzyć tę
samą sekwencję, gdy generator i środowisko pozostają niezmienione. Proweniencja
umożliwiająca powtórzenie obliczenia obejmuje zatem generator lub generator
bitów, odpowiednio ziarno lub stan, wersję oprogramowania, kod, dane i kolejność
przetwarzania. Samo ziarno nie jest kontraktem odtwarzania. W przypadku NumPy
udokumentowana gwarancja zgodności dotyczy strumienia liczb całkowitych
generatora bitów PCG64 przy określonych warunkach, natomiast Generator wyższego
poziomu nie ma ogólnej gwarancji zgodności między wersjami. Nawet gdy wyniki
losowania liczb całkowitych są zgodne, różnice platformy lub biblioteki mogą
wpłynąć na późniejsze obliczenia zmiennoprzecinkowe i zaokrąglanie.
Żadne zwykłe ziarno nie jest naukowo lepsze od innego. Uprzednie określenie go wraz z liczbą replikacji i regułą wyznaczania przedziału dokumentuje plan analizy, lecz nie uniemożliwia analitykowi wypróbowania innych ziaren. Analiza wrażliwości dotyczy niestabilności Monte Carlo, natomiast zarządzanie i ślad audytowy dotyczą wybierania pożądanego wyniku. Są to kwestie odrębne od proweniencji powtórzenia obliczenia oraz od statystycznego znaczenia samego ziarna.
Bootstrap dostarczył teraz rozkładu niepewności dla statystyki zgodności danych sparowanych. Następna sekcja stawia trudniejsze pytanie dotyczące obserwacji w czasie: jaki model błędu bezwzględnego jest potrzebny, zanim różnicę między dwoma punktami czasowymi będzie można interpretować jako zmianę?
Źródła
- Efron B. Bootstrap methods: another look at the jackknife. Annals of Statistics. 1979;7(1):1-26. doi:10.1214/aos/1176344552.
- NIST/SEMATECH e-Handbook of Statistical Methods — metody bootstrapowe i niepewność.
- Ye P, et al. BJR Open. 2022;4(1):20210083. doi:10.1259/bjro.20210083, PMID 36452056.
- Dokumentacja NumPy, Random Generator and PCG64 — oficjalna dokumentacja.
© 2026 Adrian Tkacz · BioMedical-IT
Oryginalne teksty i ilustracje są udostępniane na licencji Creative Commons Uznanie autorstwa–Użycie niekomercyjne 4.0 Międzynarodowe (CC BY-NC 4.0), o ile nie zaznaczono inaczej. Przy ponownym wykorzystaniu proszę podać Adrian Tkacz / BioMedical-IT jako autora i zamieścić odnośnik do oryginalnego źródła. Materiały osób trzecich zachowują własne prawa i warunki licencyjne.