Dyskryminacja, kalibracja, użyteczność i niepewność
Dobre porządkowanie nie oznacza jeszcze użyteczności
AUROC jest miarą dyskryminacji. Podsumowuje, jak dobrze wynik modelu porządkuje przypadki o różnych zaobserwowanych wynikach w ramach porównania reprezentowanego przez dane. Pytanie to ma znaczenie, ale nie wyczerpuje twierdzenia o działaniu modelu. Model może porządkować przypadki w użytecznej kolejności, a jednocześnie systematycznie zawyżać lub zaniżać prawdopodobieństwa, nie poprawiać żadnego dostępnego działania albo zmieniać kolejność po istotnej zmianie populacji lub akwizycji.
Trzeba zatem rozdzielić trzy pytania. Kalibracja dotyczy tego, czy przewidywane ryzyka odpowiadają zaobserwowanym częstościom zdarzeń w populacji i horyzoncie czasowym reprezentowanych przez ocenę. Użyteczność decyzyjna dotyczy tego, czy określona polityka wykorzystująca predykcje poprawia decyzje w porównaniu z istotnymi alternatywami w zakresie progów lub kosztów mającym znaczenie w zamierzonym środowisku. Niepewność dotyczy tego, jak bardzo może zmieniać się oszacowane działanie, kalibracja lub indywidualna predykcja pod wpływem określonych źródeł niepewności. Samo AUROC nie odpowiada na żadne z tych pytań.
Rozróżnienie chroni również kierunek interpretacji. Wynik modelu może być rankingiem, prawdopodobieństwem, wielkością związaną z hazardem albo sygnałem działania uzyskanym po zastosowaniu progu. Próg nabiera znaczenia dopiero po określeniu skali wyniku, definicji zdarzenia, horyzontu predykcji i konsekwencji błędów. Nie można zakładać, że ten sam próg liczbowy zachowuje to samo znaczenie decyzyjne po zmianie częstości występowania zdarzenia lub kontekstu klinicznego.
Kalibracja na konkretnym przykładzie
Wyobraźmy sobie dwa modele o takim samym rankingu, a więc również takim samym podsumowaniu dyskryminacji. W grupie, której pierwszy model przypisuje 20%, zaobserwowana częstość zdarzenia jest bliska 20%; drugi przypisuje 20% grupie, w której zaobserwowana częstość jest bliższa 40%. Ranking może być identyczny, a skale prawdopodobieństwa mogą mieć inne znaczenie. Wykresy kalibracji, odpowiednio zastosowane podsumowania kalibracji ogólnej lub nachylenia oraz właściwe reguły punktacji mogą ujawnić aspekty tej różnicy. Ich interpretacja nadal zależy od liczebności próby, grupowania, horyzontu czasowego i populacji ocenianej.
Istniejąca ilustracja syntetyczna przedstawia to bez użycia danych pacjentów:
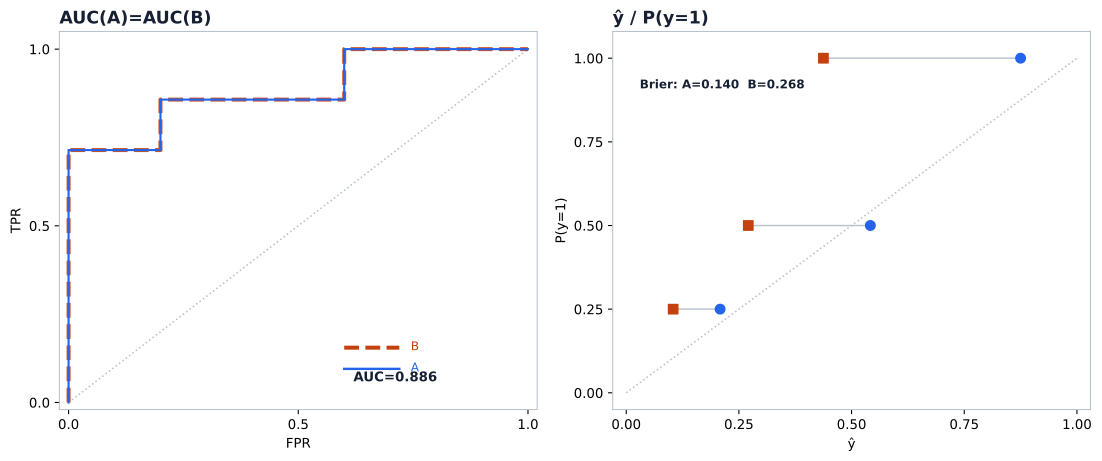
Wartości i konstrukcja złożona z dwunastu pacjentów należą do ilustracji syntetycznej, a nie do kohorty klinicznej. Identyczny ranking nie oznacza identycznego znaczenia prawdopodobieństwa.
Analiza decyzyjna dodaje politykę
Predykcja staje się częścią decyzji dopiero za pośrednictwem polityki. Analiza krzywej decyzyjnej lub korzyści netto jest jednym ze sposobów porównania polityki kierowanej przez model z alternatywami, takimi jak zastosowanie interwencji u wszystkich albo u nikogo, w zadeklarowanym zakresie prawdopodobieństw progowych. Zakres ten nie jest ozdobną osią: koduje kompromis między wynikami fałszywie dodatnimi i fałszywie ujemnymi w konkretnym zastosowaniu.
Model może zatem mieć wysoką dyskryminację, a zarazem niewielką korzyść netto lub jej brak w istotnym zakresie. Może dobrze porządkować przypadki, ale nie poprawiać działania dostępnego klinicyście. I odwrotnie, model o umiarkowanej zdolności porządkowania może być użyteczny w wąskim kontekście decyzyjnym, jeśli jego skalibrowany wynik zmienia działanie w sposób mający znaczenie. We wniosku trzeba nazwać politykę, punkt odniesienia, zakres progów, horyzont zdarzenia i populację, zamiast nazywać model użytecznym klinicznie w oderwaniu od kontekstu.
Użyteczność nie zastępuje kalibracji. Analiza decyzyjna może wprowadzać w błąd, jeśli wynik, próg albo definicja zdarzenia nie są odpowiednie dla danego środowiska. Użyteczność nie zastępuje też przenoszalności: polityka pomagająca w jednej populacji źródłowej może nie zachować korzyści netto po zmianie częstości występowania zdarzenia, przebiegu pracy lub warunków pomiaru.
Niepewność wymaga właściwego obiektu
Przedział wokół zagregowanej statystyki opisuje niepewność tej statystyki w ramach zadeklarowanej procedury próbkowania lub resamplingu. Przedział dla AUROC, C-index, wyniku Briera lub podsumowania kalibracji kwantyfikuje w tej procedurze niepewność oszacowanego obiektu działania na poziomie populacji. Nie staje się przez to przedziałem wyniku ani ryzyka jednej osoby.
Niepewność dopasowanego wyrazu wolnego, nachylenia lub krzywej kalibracji dotyczy oszacowanej relacji między predykcjami a zaobserwowanymi częstościami w określonej populacji i horyzoncie. Jest odrębna od niepewności dyskryminacji oraz od niepewności ryzyka jednej osoby.
Dla określonego profilu zmiennych ponowne dopasowywanie lub bootstrap może ujawnić zmienność ryzyka oszacowanego przez model, wynikającą z próbkowania i dopasowania. Błąd pomiaru i zmiana rozkładu danych dodają kolejne źródła zmienności. Taki przedział dotyczy oszacowanego ryzyka przy założeniach o modelu i procesie generującym dane; nie jest obserwacją ukrytego, prawdziwego prawdopodobieństwa tej osoby.
Przedział lub zbiór predykcji przyszłego wyniku jest innym obiektem. Predykcja konforemna może wytwarzać zbiory lub przedziały przyszłych wyników o określonym pokryciu marginalnym przy założeniu wymienialności. Dla wyniku binarnego efektem jest zbiór predykcji, a nie konwencjonalny przedział dla wyniku ciągłego. Pokrycie marginalne nie jest indywidualną gwarancją warunkową i nie kalibruje ukrytego ryzyka danej osoby.
Czytając raport działania modelu, należy zapytać, do którego obiektu należy stwierdzenie o niepewności: zagregowanej miary, dopasowanej relacji kalibracyjnej, oszacowanego ryzyka dla określonego profilu osoby, zbioru lub przedziału predykcji przyszłego wyniku czy polityki decyzyjnej. Trzeba też zapytać, czy istotnym źródłem zmienności jest próbkowanie, dopasowanie modelu, pomiar, zmiana domeny, brakujące dane, czy ich połączenie. Jeden przedział nie może milcząco odpowiadać na wszystkie te pytania.
Ta sama dyscyplina dotyczy wyboru progu. Próg wybrany po obejrzeniu wyników w danych testowych jest częścią dopasowanej lub wybranej procedury. Jeśli zostanie ponownie oszacowany w nowym środowisku, uzyskana czułość, swoistość lub użyteczność należy do zmienionej polityki i nie może być raportowana jako działanie nietkniętego modelu bez ujawnienia tej zmiany.
Dyskryminacja, kalibracja, użyteczność i niepewność tworzą zatem zbiór powiązanych, lecz niewymiennych pytań. Następna sekcja dotyczy rodzaju reprezentowanego środowiska testowego i tego, jak daleko model rzeczywiście został przeniesiony, zanim sformułowano twierdzenie o uogólnianiu.
Źródła
- Collins GS, Moons KGM, Dhiman P, et al. TRIPOD+AI statement. BMJ. 2024;385:e078378. doi:10.1136/bmj-2023-078378.
- Kocak B, et al. CLEAR radiomics reporting checklist. Insights into Imaging. 2023;14:75. doi:10.1186/s13244-023-01415-8.
- Van Calster B, et al. Calibration: the Achilles heel of predictive analytics. BMC Medicine. 2019;17:230. doi:10.1186/s12916-019-1466-7.
- Vickers AJ, Elkin EB. Decision Curve Analysis. Medical Decision Making. 2006;26:565-574. doi:10.1177/0272989X06295361.
- Collins GS, et al. Evaluation of clinical prediction models (part 2): how to undertake an external validation study. BMJ. 2024;384:e074820. PMC10788734.
- Riley RD, et al. Uncertainty of risk estimates from clinical prediction models: rationale, challenges, and approaches. BMJ. 2025;388:e080749. doi:10.1136/bmj-2024-080749; PMC12128882.
- Angelopoulos AN, Bates S. A Gentle Introduction to Conformal Prediction and Distribution-Free Uncertainty Quantification. Foundations and Trends in Machine Learning. 2023;16:494-591. arXiv:2107.07511.
© 2026 Adrian Tkacz · BioMedical-IT
Oryginalne teksty i ilustracje są udostępniane na licencji Creative Commons Uznanie autorstwa–Użycie niekomercyjne 4.0 Międzynarodowe (CC BY-NC 4.0), o ile nie zaznaczono inaczej. Przy ponownym wykorzystaniu proszę podać Adrian Tkacz / BioMedical-IT jako autora i zamieścić odnośnik do oryginalnego źródła. Materiały osób trzecich zachowują własne prawa i warunki licencyjne.