Ocena i diagnozowanie podgrup
Główna metryka jest obserwacją częściową
Każda klasa modeli ma metrykę, którą łatwo umieścić w nagłówku. Dice podsumowuje nakładanie segmentacji, AUROC jeden aspekt zdolności rozróżniania klasyfikatora, a SSIM lub PSNR jeden rodzaj podobieństwa obrazów. Każda z tych miar może być użyteczna. Żadna nie stanowi werdyktu o pełnym celu modelu. Brakujące aspekty wynikają z zadania: dla maski są to błąd przestrzenny i dalszy pomiar, dla wyniku ryzyka — kalibracja i konsekwencje decyzyjne, a dla obrazu syntetycznego — patologia i użyteczność w zadaniu.
Niepewność również wymaga precyzyjnego określenia obiektu. Przedział wokół zagregowanego AUROC opisuje niepewność oszacowanego podsumowania populacyjnego według zadeklarowanej estymandy oraz procedury wyznaczania przedziału lub resamplingu. Raport powinien nazwać oba te elementy. Nie jest to automatycznie przedział przyszłego wyniku lub ryzyka pojedynczego pacjenta. Niepewność kalibracji, niepewność skuteczności modelu i niepewność pojedynczej predykcji mogą mieć różne źródła i nie należy ich łączyć pod nazwą „przedział ufności na poziomie pacjenta” bez zdefiniowania estymowanej wielkości.
Ocena odpowiada zadaniu i twierdzeniu
W segmentacji nakładanie należy interpretować wraz z zachowaniem powierzchni, wynikami dla poszczególnych struktur, zmiennością między oceniającymi referencyjnymi oraz dalszym pomiarem umożliwianym przez maskę. W klasyfikacji zdolność rozróżniania należy oddzielić od kalibracji, wartości predykcyjnych, użyteczności zależnej od progu i niepewności. W syntezie podobieństwu wizualnemu lub pikselowemu powinny towarzyszyć kontrole anatomiczne, patologiczne, ilościowe i kontrole dalszego zadania. Detekcja, rejestracja i inne zadania także wymagają miar odpowiadających ich wynikowi i zastosowaniu; żadna pozycja listy kontrolnej niezależna od modelu nie zastąpi kontraktu zadania.
Warunki oceny są częścią twierdzenia. Testy wewnętrzne, czasowe i zewnętrzne ujawniają różne zmiany populacji, akwizycji, ośrodka lub czasu. Raport powinien określać, czy model i jego próg zostały dla ocenianego środowiska zamrożone, ponownie skalibrowane, zaadaptowane czy ponownie wytrenowane. Wynik po adaptacji może być wartościowy, ale nie jest tym samym co test przenoszalności zamrożonego modelu.
Analiza awarii pozwala interpretować średnią. Kontrola dla poszczególnych struktur, podgrup i przypadków może ujawnić błędy skupione w małych strukturach, nietypowej anatomii, zmienionych warunkach akwizycji albo konkretnym punkcie operacyjnym. Podgrupy i analizy należy zadeklarować przed wielokrotnym przeszukiwaniem wyników, a oszacowania powinny mieć niepewność odpowiednią do ich jednostki i metryki. Przyjmuje się, że AUROC nie zmienia się wskutek samej częstości klas tylko wtedy, gdy warunkowe względem klas rozkłady wyniku są stałe, natomiast wartości predykcyjne i użyteczność zależna od progu zależą od częstości i reguły działania. Zanim raportowaną różnicę skuteczności wyjaśni się jako właściwość ośrodka lub populacji, trzeba sprawdzić porównywalność metryki i danych wejściowych. Porównania ośrodków nie można więc interpretować wyłącznie przez częstość: najpierw należy sprawdzić spektrum, dane wejściowe, etykiety i rozkłady wyniku.
Różnica między podgrupami otwiera przestrzeń hipotez
Rozważ ustalone syntetyczne porównanie ośrodków na rycinie. Zostało celowo skonstruowane tak, aby pokazać wynik ogólny obok odstającego ośrodka, a nie raportować wynik szpitala, skanera lub zastosowania klinicznego. Pierwsze pytanie jest mechaniczne i poprzedza hipotezy przyczynowe: czy ośrodki zastosowały tę samą metrykę, definicję wyniku, regułę progową, procedurę referencyjną i porównywalne dane wejściowe? Różnica spowodowana zmianą punktu operacyjnego lub metryki nie dowodzi, że model zachowuje się inaczej w populacji reprezentowanej przez ośrodek.
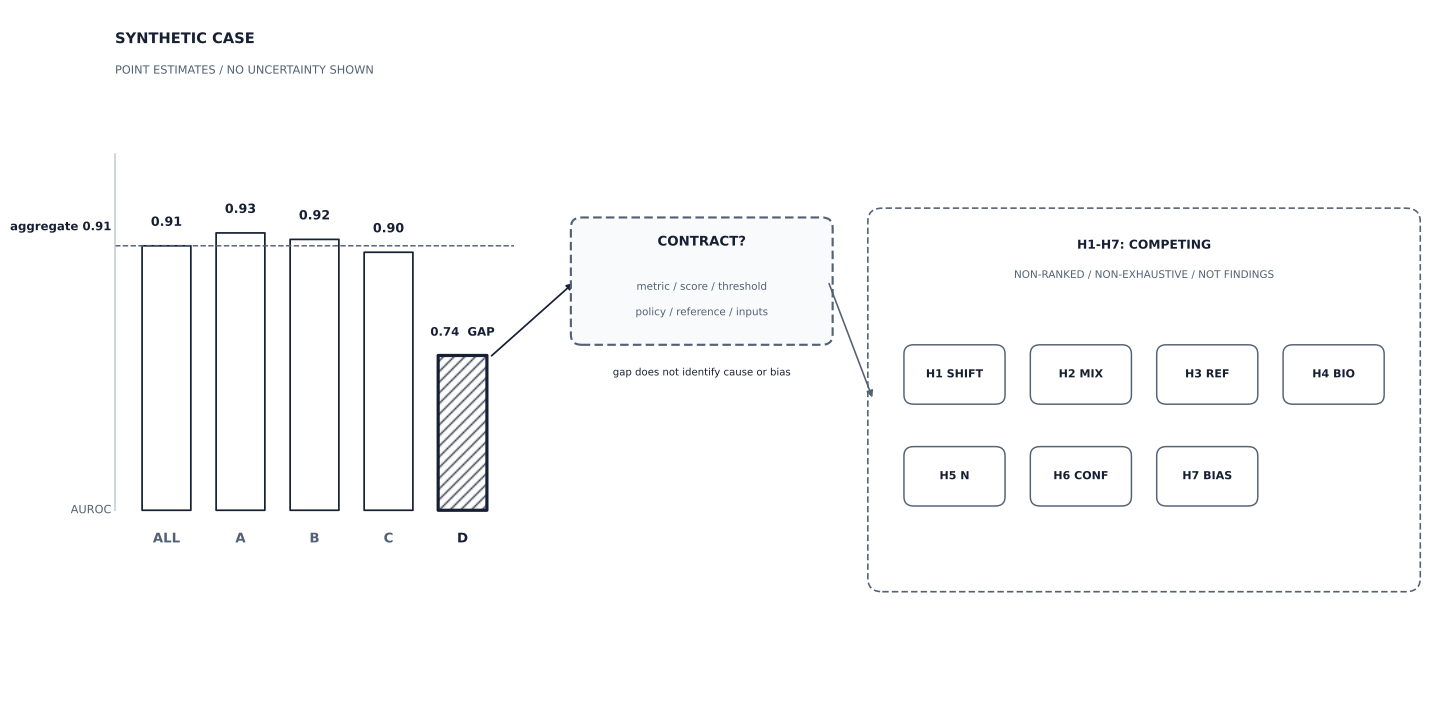
Syntetyczne estymaty punktowe, a nie wyniki szpitala lub modelu; nie przedstawiono przedziału niepewności. Przed przejściem do H1-H7 należy potwierdzić kontrakt metryki, wyniku, reguły progowej, procedury referencyjnej i danych wejściowych. Siedem równorzędnych pól przedstawia niewyczerpujące hipotezy bez ustalonej hierarchii, a nie ustalenia; sama różnica nie dowodzi ani przyczyny, ani szkodliwego obciążenia, a więcej niż jeden mechanizm może współistnieć.
Po ustaleniu porównywalności należy zachować odrębność poniższych siedmiu wyjaśnień. Traktuj je jako H1-H7: jawne, bez ustalonej hierarchii i niewyczerpujące hipotezy do zbadania, a nie ustalenia; więcej niż jedna może być prawdziwa jednocześnie.
- H1 — Zmiana techniczna lub domenowa: skaner, rekonstrukcja, dawka, protokół lub warunki ośrodka mogą przesuwać rozkład danych wejściowych. Odpowiedzią jest zmierzenie zmiany i sprawdzenie właściwej strategii adaptacji lub treningu, a nie domyślne nazwanie różnicy biologiczną.
- H2 — Skład przypadków lub efekt spektrum: podgrupa może zawierać inną mieszaninę ciężkości choroby, rozmiaru zmian, historii leczenia albo kontekstu kierowania pacjentów. Ten sam model może osiągać inne wyniki dla innej mieszaniny, co samo w sobie nie dowodzi niesprawiedliwości.
- H3 — Różnice standardu referencyjnego: etykiety lub procedury adnotacji mogą różnić się między ośrodkami. Pozorna różnica może częściowo opisywać cel użyty do oceny, a nie zmianę zachowania modelu.
- H4 — Biologia: choroba może mieć w podgrupie inną ekspresję obrazową. Różnica skuteczności może odzwierciedlać rzeczywistą zmienność, ale taka interpretacja nadal wymaga dowodów i nie uzasadnia automatycznie twierdzenia o wdrożeniu.
- H5 — Niepewność małej próby: oszacowanie dla podgrupy może być znacznie mniej precyzyjne niż oszacowanie zagregowane. Zanim estymatę punktową uzna się za stabilną różnicę, potrzebne są przedziały lub inna odpowiednia analiza niepewności.
- H6 — Ukryte zmienne zakłócające: zmienna podgrupy może być wskaźnikiem niemierzonego czynnika, takiego jak ścieżka kierowania, choroba współistniejąca, wcześniejsze obrazowanie lub okres akwizycji. Taki wskaźnik i jego relacja z wynikiem wymagają zbadania.
- H7 — Rzeczywiste szkodliwe obciążenie: zasadniczym problemem jest szkoda dla pacjentów z podgrupy. Nie jest to kategoria resztkowa, która staje się możliwa dopiero po wykluczeniu zmiany domenowej, różnic etykiet i zmiennych zakłócających; szkodliwe skutki mogą działać poprzez te mechanizmy lub z nimi współistnieć.
Są to konkurencyjne wyjaśnienia obserwowanego sygnału, a nie ranking ani wyczerpująca taksonomia. Każde prowadzi do innej następnej analizy. Zmiana techniczna może wymagać charakterystyki akwizycji i testowania przenoszalności. Skład przypadków może wymagać raportowania warstwowego. Różnica odniesienia wymaga przeglądu adnotacji. Małe próby wymagają bardziej informacyjnego opisu niepewności. Zmienna zakłócająca wymaga pracy nad projektem lub pomiarem. Dowody szkodliwego wpływu na pacjentów mogą zmienić decyzję wdrożeniową nawet wtedy, gdy udział ma także inny mechanizm.
Twierdzenie zmienia się wraz z postępowaniem wyjaśniającym
Sam zagregowany wynik jest niepełny po zaobserwowaniu istotnej różnicy między podgrupami. Odpowiedzialne stwierdzenie obejmuje wynik podgrupy, jego niepewność, kontrakt metryki i danych wejściowych oraz wyjaśnienie, które pozostaje przedmiotem badania. Nie powinno przeskakiwać od różnicy do twierdzenia o niesprawiedliwości, ale nie powinno też odrzucać różnicy jako nieszkodliwej zmienności biologicznej bez sprawdzenia alternatyw i konsekwencji dla pacjentów.
Wstępne określenie analiz ma znaczenie, ponieważ przeszukiwanie wielu podgrup i metryk po zobaczeniu wyników zwiększa szansę przypadkowego znalezienia pozornej różnicy. Nie czyni to sygnału znalezionego post hoc nieistotnym; zmienia siłę, z jaką można go przedstawić, oraz wymagany rodzaj potwierdzenia. Dodatkowa ocena powinna być proporcjonalna do twierdzenia: porównywalność metryk, przegląd składu przypadków i etykiet, niepewność, kalibracja, wartości predykcyjne, reguła progowa i użyteczność w zadaniu mogą mieć znaczenie, ale odpowiadają na różne pytania.
Taką perspektywę ewaluacyjną należy stosować przy ocenie publikacji: przed zaakceptowaniem pojedynczego wyniku trzeba odtworzyć zadanie, odniesienie, testowane środowisko, dopasowany stan i tryby awarii. Ostatnia część stosuje tę samą logikę do porównań reprezentacji, w których bardziej złożona tabela cech musi wykazać przyrost ponad prostsze punkty odniesienia oparte na danych klinicznych i pomiarach.
© 2026 Adrian Tkacz · BioMedical-IT
Oryginalne teksty i ilustracje są udostępniane na licencji Creative Commons Uznanie autorstwa–Użycie niekomercyjne 4.0 Międzynarodowe (CC BY-NC 4.0), o ile nie zaznaczono inaczej. Przy ponownym wykorzystaniu proszę podać Adrian Tkacz / BioMedical-IT jako autora i zamieścić odnośnik do oryginalnego źródła. Materiały osób trzecich zachowują własne prawa i warunki licencyjne.