Segmentacja i ocena dostosowana do zadania
Maskę ocenia się przez jej dalsze zastosowanie
Gdy maskę rozumie się jako infrastrukturę pomiarową, wynik segmentacji nie może już stanowić całego wniosku. Dice mierzy nakładanie się predykcji z odniesieniem. W notacji zbiorów jest to podwojona wielkość części wspólnej podzielona przez sumę objętości obu masek. To użyteczne pytanie, ale tylko jedno z wielu. To samo bezwzględne przesunięcie granicy może mieć duży skutek względny dla małej struktury i mniejszy dla dużej. Duże nakładanie dużej struktury może też współistnieć z miejscowym odchyleniem istotnym dla pomiaru wrażliwego na granicę.
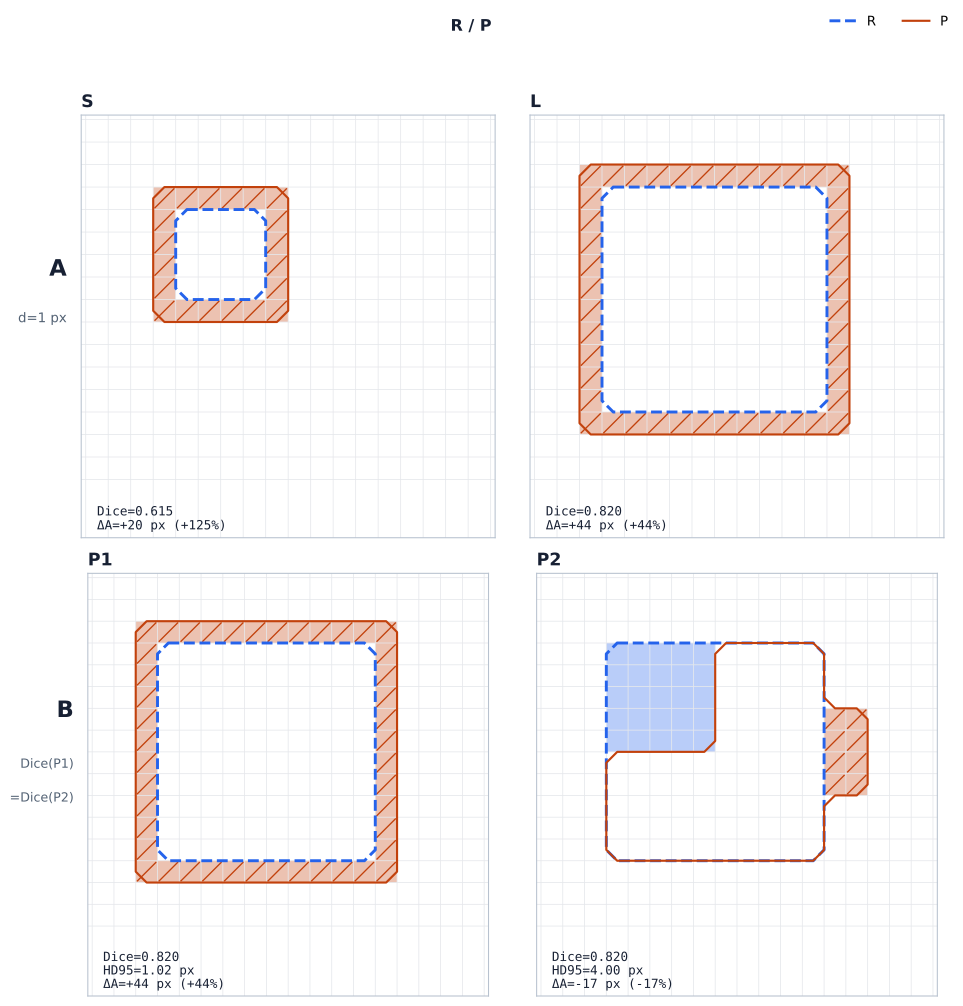
S i L są syntetycznymi maskami odniesienia o różnych rozmiarach; w całej rycinie linie przerywane wyznaczają odniesienie S, L lub R, natomiast ciągłe, szrafowane obrysy oznaczają predykcję P, czyli S′, L′, P1 lub P2. W panelu A do obu masek zastosowano tę samą dylatację na zewnątrz o jeden piksel z elementem strukturalnym 3×3, a Dice obliczono z narysowanych masek: 32/52 ≈ 0,615 dla S wobec 200/244 ≈ 0,820 dla L. Ta sama dylatacja granicy stanowi dużą zmianę względną dla małej struktury, a małą dla dużej. W panelu B zachowano jedno odniesienie R i porównano dwie predykcje: P1 jest dylatacją na zewnątrz o jeden piksel; w P2 usunięto narożne wycięcie 5×5 (25 px) i dodano wypustkę 4×2 przy krawędzi (8 px). Obie predykcje mają Dice 200/244 = 150/183 ≈ 0,820 — z założenia dokładnie taki sam — lecz HD95, czyli 95. percentyl połączonych odległości między powierzchniami (a nie najgorszy przypadek), wynosi 1,02 px dla P1 i 4,00 px dla P2. Wynikowa zmiana pola ΔA = area(P) − area(R) to +44 px dla P1 i −17 px dla P2. Takie samo nakładanie nie oznacza takiego samego błędu przestrzennego ani takiego samego dalszego pomiaru; te syntetyczne liczby są ilustracjami, a nie progami klinicznymi, zaś Dice pozostaje użyteczny — po prostu nie wystarcza. To, która różnica ma znaczenie, zależy od zadania docelowego.
Nakładanie, odległość między powierzchniami i rozmiar odpowiadają na różne pytania
IoU, nazywany również indeksem Jaccarda, jest innym podsumowaniem nakładania o
tym samym ogólnym ograniczeniu: jego reakcja zależy od struktury i geometrii
błędu. Miary odległości między powierzchniami zadają inne pytanie o odległość
między granicami. Rodzina odległości Hausdorffa może zostać zdominowana przez
punkt skrajny, natomiast wariant percentylowy ogranicza wpływ takiego punktu
odstającego. Etykieta HD95 nie definiuje jednak jednej uniwersalnej
implementacji. Aby można było porównać dwie wartości, badanie musi określić
konstrukcję powierzchni, kierunkowość, symetrię, sposób łączenia odległości,
odstępy oraz konwencję percentyla. Średnia lub przeciętna odległość między
powierzchniami podsumowuje typową odległość według własnej konwencji; nie
zastępuje nakładania ani konsekwencji dla zadania docelowego.
Dlatego ważne jest raportowanie osobno dla każdej struktury. Jedna wartość zbiorcza może ukryć awarię skupioną w małych lub cienkich strukturach, a jedna miara powierzchniowa może ukryć rozległą, lecz umiarkowaną utratę nakładania. Zestaw metryk należy dobierać do zamierzonego zastosowania, a szczegóły implementacji powinny stanowić część raportowanego pomiaru, zamiast być domyślnie wywodzone z powszechnie znanej nazwy metryki.
Kilka przypadków brzegowych wymaga własnych, jawnie określonych konwencji. Gdy zarówno predykcja, jak i odniesienie są puste, gdy klasy nie ma w jednej lub obu maskach albo gdy brakuje oczekiwanej struktury, należy wskazać, czy przypadek uznaje się za zgodność, za niezdefiniowany, za błąd, czy też się go wyklucza; domyślne zachowanie oprogramowania nie powinno po cichu wybierać estymandy. Małe lub cienkie struktury trzeba raportować osobno, ponieważ przesunięcie granicy może zdominować podsumowanie. Należy również określić, czy agregacja odbywa się według przypadków, struktur, jako makro- lub mikrośrednia, czy też jest ważona objętością, ponieważ nierówne ważenie zmienia pytanie, na które odpowiada wynik. Dla miary odległości powierzchniowej trzeba zadeklarować konstrukcję powierzchni, jednostki wokselowe lub fizyczne, kierunkowość, symetrię, sposób łączenia, odstępy, percentyl i obsługę pustej powierzchni. Na koniec należy wskazać co najmniej jeden ilościowy punkt końcowy związany z zadaniem, na przykład błąd objętości fizycznej w wolumetrii albo stabilność cechy przy zadeklarowanym zaburzeniu maski w radiomice, wraz z procedurą określania jego niepewności. Konwencje te pozwalają interpretować wynik; nie czynią jednej metryki ani jednej maski uniwersalnie poprawną.
Etykiety referencyjne są pomiarami o własnej zmienności
Maska referencyjna jest na ogół adnotacją, a nie nieomylną granicą istniejącą w naturze. Oceniający mogą różnić się w ocenie niewyraźnych krawędzi, małych zmian chorobowych lub właściwego zasięgu obszaru. Odniesienie uzgodnione albo ustalone po rozstrzygnięciu niezgodności może być użyteczne, ale reprezentuje określoną procedurę adnotacji i nie musi pokrywać się z oceną każdego pojedynczego oceniającego. Rozrzut między oceniającymi stanowi więc kontekst interpretacji różnicy modelu, a nie uniwersalny liczbowy pułap, którego model nie może przekroczyć.
Porównanie musi również odpowiadać zamierzonemu celowi. Model zaprojektowany do odtwarzania adnotacji jednego oceniającego nie powinien być oceniany tak, jakby estymował konsensus ustalony po rozstrzygnięciu, bez wyjaśnienia tej zmiany. Z drugiej strony zgodność z konsensusem nie dowodzi zgodności z każdym oceniającym ani z każdym pomiarem na dalszym etapie. Niewielka różnica między dwiema wartościami miary nakładania pozostaje niemożliwa do interpretacji, dopóki nie są widoczne procedura wyznaczania odniesienia, próba, niepewność i zadanie.
Dalszy pomiar dopełnia ocenę
Załóżmy, że dwie maski mają podobne nakładanie względem tego samego odniesienia. W przypadku z góry określonego dalszego pomiaru maska dająca oszacowanie bliższe zamierzonemu pomiarowi, z określoną niepewnością, może być użyteczniejsza w tym zadaniu niż maska z miejscowym odchyleniem granicy, które obciąża oszacowanie. Maska o niższym Dice może być preferowana w jednym zadaniu pomiarowym, a maska o wyższym Dice w innym. Nie jest to paradoks; odzwierciedla różne estymandy, które trzeba zadeklarować, zanim jedną z masek nazwie się użyteczniejszą. Słowo „użyteczna” oznacza zatem jakościowy wniosek swoisty dla zadania, a nie ranking wyznaczony wyłącznie przez Dice.
Ocena modelu wytwarzającego obszar powinna więc łączyć co najmniej cztery warstwy: nakładanie, przestrzenne zachowanie granicy, zmienność standardu referencyjnego i zadanie docelowe. Wizualna kontrola jakości może uzupełnić te analizy, sprawdzając anatomię i geometrię, ale wrażenie wizualne nie jest liczbowym oszacowaniem zgodności pomiarów. Ani kontrola wizualna, ani zestaw metryk segmentacji — osobno czy łącznie — nie poświadczają poprawności punktu końcowego na dalszym etapie; wymaga to oceny zadeklarowanego pomiaru. Następna część przechodzi od oceny maski do konfiguracji potoku segmentacyjnego. To samo rozróżnienie nie pozwala automatycznie przypisać raportowanej przewagi architekturze, gdy może ona wynikać ze zmiany przetwarzania wstępnego, odstępów lub procedury treningowej.
© 2026 Adrian Tkacz · BioMedical-IT
Oryginalne teksty i ilustracje są udostępniane na licencji Creative Commons Uznanie autorstwa–Użycie niekomercyjne 4.0 Międzynarodowe (CC BY-NC 4.0), o ile nie zaznaczono inaczej. Przy ponownym wykorzystaniu proszę podać Adrian Tkacz / BioMedical-IT jako autora i zamieścić odnośnik do oryginalnego źródła. Materiały osób trzecich zachowują własne prawa i warunki licencyjne.