Zagnieżdżony wybór modelu
Strojenie w raportowanych foldach jest ocenianiem własnej pracy
Walidację krzyżową opisuje się często tak, jakby wytwarzała jedną liczbę niezależnie od tego, co wydarzyło się przed jej obliczeniem. Tak nie jest. Jeśli w badaniu sprawdza się wiele zbiorów cech, kar, progów lub konfiguracji modelu, a następnie raportuje najlepszy wynik z tych samych foldów, które wykorzystano do przeszukiwania, foldy pełniły dwie funkcje: wybrały procedurę i ją oceniły. Raportowana wartość jest wtedy wynikiem wybranego zwycięzcy, a nie nietkniętym oszacowaniem procedury przeszukiwania.
Problem występuje nawet wtedy, gdy każdą konfigurację kandydującą ocenia się starannie. Dostatecznie szerokie przeszukiwanie może znaleźć konfigurację, która wygląda dobrze w konkretnych foldach częściowo wskutek zmienności próbkowania. Wybranie tej konfiguracji uzależnia raportowaną liczbę od wyniku przeszukiwania. Nie oznacza to, że zwycięski model jest z konieczności bezużyteczny; problem polega na tym, że liczby nie uzyskano na danych pozostających poza wyborem, który ją wytworzył.
Pytania pętli wewnętrznej i zewnętrznej
Zagnieżdżona walidacja krzyżowa rozdziela te dwie funkcje. Pętla wewnętrzna wykorzystuje wyłącznie zewnętrzną część treningową do porównywania konfiguracji kandydujących i wyboru cech, hiperparametrów lub innych wyborów zależnych od danych. Wybrana procedura jest następnie ponownie dopasowywana do całej zewnętrznej części treningowej. Pętla zewnętrzna ocenia tę dopasowaną procedurę jeden raz na swojej części wydzielonej, która nie była dostępna dla przeszukiwania wewnętrznego. Powtarzanie tego procesu w foldach zewnętrznych daje zbiór wyników kompletnej procedury wyboru i dopasowania.
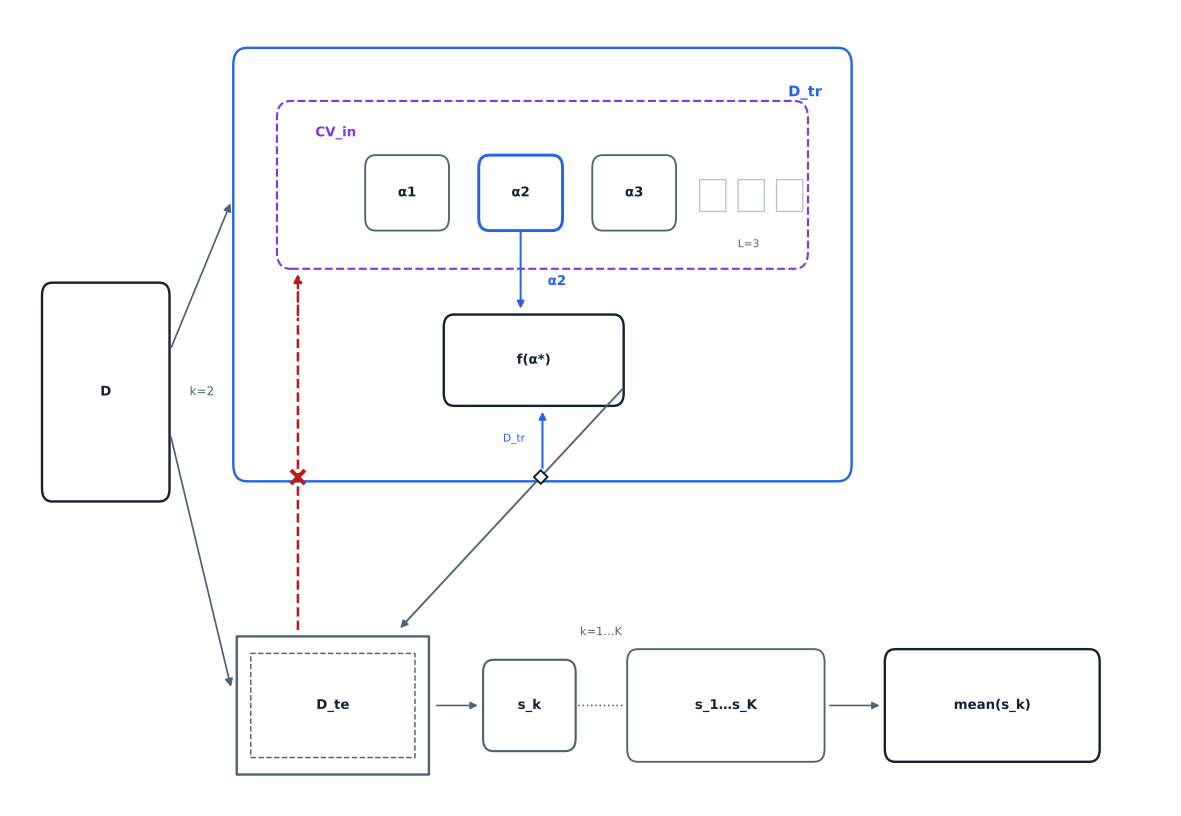
Rysunek przedstawia kolejność operacji, a nie uniwersalny wybór liczby foldów lub siatki konfiguracji kandydujących. Zewnętrzna część wydzielona pozostaje poza światem selekcji. Oszacowanie opisuje zadeklarowaną procedurę grupowego resamplingu oraz wyboru i dopasowania; model później ponownie wytrenowany na wszystkich dostępnych danych ma inne dopasowane wagi.
Ta sama granica dotyczy nie tylko parametru kary. Wybór cech, skalowanie, imputacja, harmonizacja i każde inne zależne od danych przekształcenie wejściowe muszą być dopasowywane w dozwolonej części treningowej. Gdy zamierzony estymand wymaga grupowania, obie pętle muszą zachowywać grupowanie pacjentów lub skupień. W przeciwnym razie diagram wyglądający na zagnieżdżony może nadal zawierać wyciek przez dane przekazane do jednego z etapów.
Zagnieżdżona walidacja krzyżowa szacuje oczekiwane działanie procedury, która była wielokrotnie wybierana i dopasowywana w ramach zadeklarowanego projektu. Sama w sobie nie wykazuje działania w innym ośrodku, nie ustala efektu przyczynowego ani nie dowodzi, że wybrane cechy reprezentują zamierzoną biologię. Są to odrębne twierdzenia wymagające własnych projektów.
Szkic liczbowy, a nie zmierzony wynik
Załóżmy, że w skonstruowanym przykładzie porównuje się kilka kar lasso za pomocą płaskiej pięciokrotnej walidacji krzyżowej i raportuje zwycięskie AUROC równe 0,88. Po umieszczeniu tego samego przeszukiwania wewnątrz pętli zewnętrznej średni wynik zewnętrzny w ilustracji może wynieść 0,82. Różnica jest schematycznym przedstawieniem optymizmu selekcyjnego: przeszukiwanie wewnętrzne mogło wybrać zwycięzcę, podczas gdy foldy zewnętrzne oceniają procedurę bez udziału w tym wyborze. Wartości te nie są wynikiem z kohorty pacjentów i nie należy przenosić ich do badania jako oczekiwanej różnicy.
Użyteczne porównanie nie brzmi „wynik zagnieżdżony jest zawsze niższy”. Należy zapytać, czy raportowany wynik należy do procedury, której wybory podejmowano bez odczytywania obserwacji wykorzystanych do obliczenia tego wyniku. Model określony z góry, bez wyboru zależnego od danych, może wymagać prostszego projektu. Szerokie przeszukiwanie radiomiczne obejmujące wiele skorelowanych cech i małą liczbę pacjentów wymaga projektu, który konfrontuje przeszukiwanie z rzeczywiście wydzielonymi ocenami.
Kiedy dodatkowa pętla uzasadnia swój koszt
Koszt obliczeniowy zagnieżdżonej walidacji rośnie wraz z liczbą dopasowań zewnętrznych i wewnętrznych. Jest uzasadniony, gdy selekcja stanowi istotną część analizy: przy wielu cechach kandydujących, agresywnym strojeniu, licznych wariantach przetwarzania wstępnego albo małej kohorcie, w której przypadkowe różnice mogą zdecydować o zwycięzcy. Jeśli procedurę ustalono z góry, a ocena ma jedynie oszacować jej działanie, problem selekcji jest mniejszy, choć granice podziału, dopasowanego stanu i niepewności nadal obowiązują.
Skrót taki jak K x L jest wyłącznie schematycznym opisem kosztu. K oznacza
tutaj liczbę foldów zewnętrznych, a L trzeba rozumieć jako pełne obciążenie
pracą pętli wewnętrznej przypadające na fold zewnętrzny, w tym dopasowania
konfiguracji kandydujących, przetwarzanie wstępne zależne od danych oraz ponowne
dopasowanie w zewnętrznej części treningowej. Nie jest to uniwersalny wzór na
czas wykonania. Podział grupowy jest odrębnym warunkiem projektowym wybieranym
zgodnie z estymandem i strukturą zależności, a nie właściwością zapewnianą przez
samo zagnieżdżenie.
Końcowy model używany po fazie tworzenia może zostać ponownie wytrenowany na wszystkich dozwolonych danych z konfiguracją wybraną zgodnie z zadeklarowaną procedurą. Nie jest to obiekt o dokładnie tych samych wagach, które oceniano w każdym foldzie zewnętrznym. Wyniki zewnętrzne opisują oczekiwane zachowanie procedury w ramach projektu resamplingu, a nie gwarancję dla jednego przyszłego dopasowania ani dla niesprawdzonej domeny.
Ograniczone powiązanie z projektem
Protokół projektu może uczynić tę strukturę audytowalną, jeśli przed wykonaniem zapisze jednostkę podziału, operacje, które wolno dopasowywać w każdej pętli, oraz granicę selekcji konfiguracji kandydujących. Kontrola odtwarzalności procesu generowania cech może ustabilizować dane wejściowe na tyle, by można je było porównywać, ale sama nie dowodzi przeprowadzenia zagnieżdżonej walidacji ani uogólniania uzyskanego modelu. Wnioski te pozostają właściwościami zarejestrowanego projektu walidacji i jego dowodów.
Następna sekcja wyjaśnia, dlaczego wybór cech jest szczególnie kruchy, gdy liczba kandydujących kolumn jest duża w stosunku do liczby pacjentów.
Źródła
- James G, Witten D, Hastie T, Tibshirani R, Taylor J. An Introduction to Statistical Learning with Applications in Python. Springer; 2023.
- Varma S, Simon R. Bias in error estimation when using cross-validation for model selection. BMC Bioinformatics. 2006;7:91. doi:10.1186/1471-2105-7-91.
- Cawley GC, Talbot NLC. On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation. Journal of Machine Learning Research. 2010;11:2079-2107. publikacja w JMLR.
© 2026 Adrian Tkacz · BioMedical-IT
Oryginalne teksty i ilustracje są udostępniane na licencji Creative Commons Uznanie autorstwa–Użycie niekomercyjne 4.0 Międzynarodowe (CC BY-NC 4.0), o ile nie zaznaczono inaczej. Przy ponownym wykorzystaniu proszę podać Adrian Tkacz / BioMedical-IT jako autora i zamieścić odnośnik do oryginalnego źródła. Materiały osób trzecich zachowują własne prawa i warunki licencyjne.